Hallo,
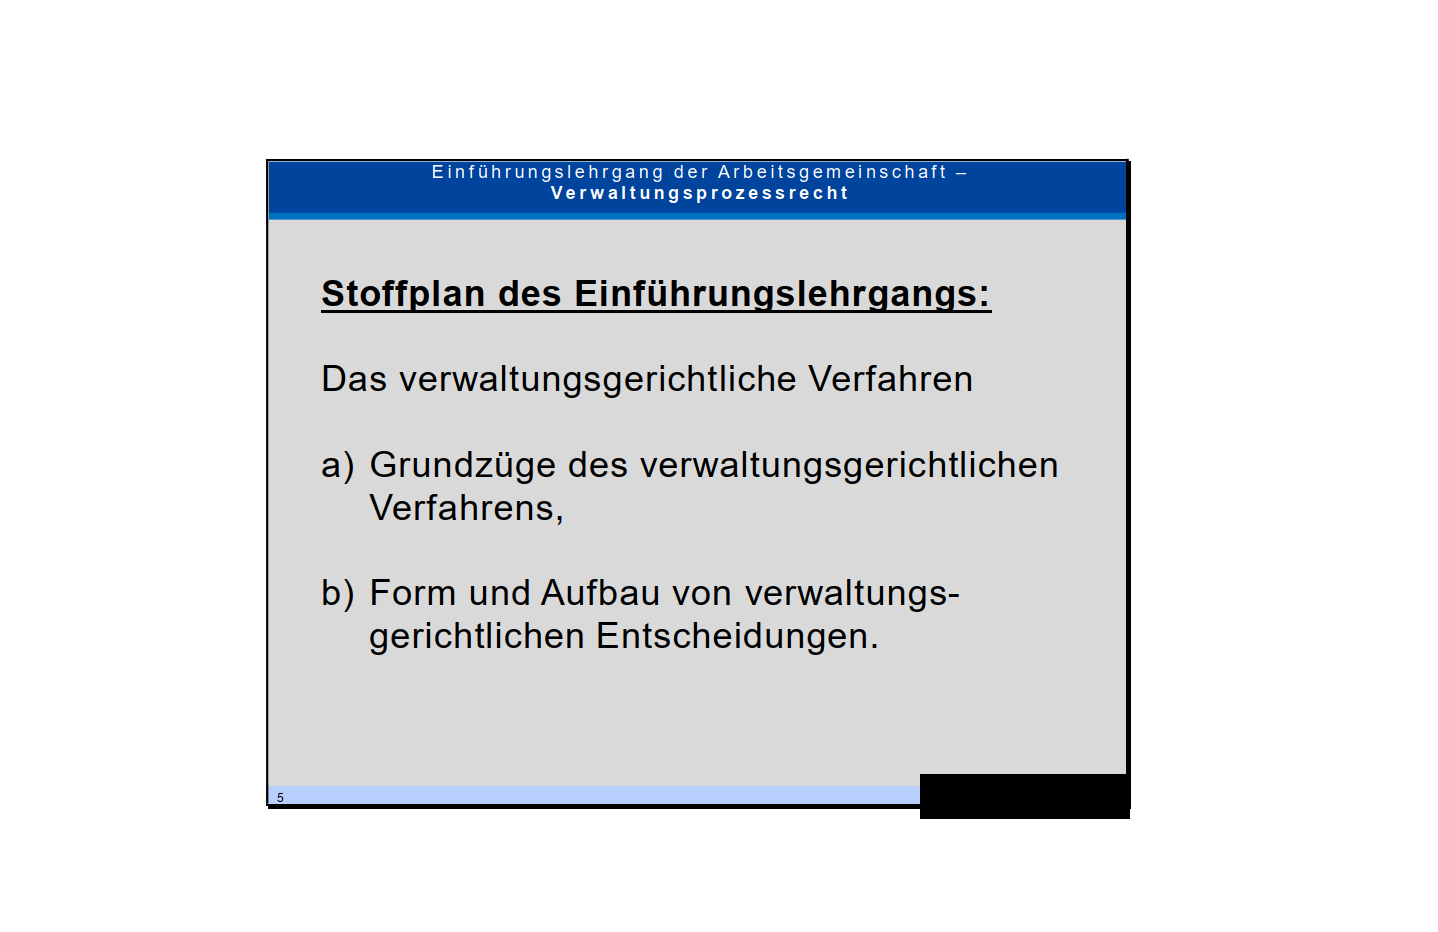
danke für die Meldung und die Bilder. Die Option "Vorhandenen Text entfernen" entfernt vor der Erkennung allen Text aus der PDF, nicht nur eine unsichtbare Textebene im Hintergrund. In Ihrer Datei ist der sichtbare Text echter Text und kein gescanntes Bild. Er wird deshalb ebenfalls entfernt, und danach findet die Texterkennung auf der Seite nichts mehr.
Lassen Sie die Option bei solchen Dateien bitte aus. Sie ist für gescannte PDFs gedacht, deren vorhandene Textebene ersetzt werden soll. Wir haben aufgenommen, dass die Option sichtbaren Text nicht entfernen bzw. vorher deutlich darauf hinweisen soll.
Der Tippfehler "orhandenen" ist seit Version 11.23.0 behoben.
Die Texterkennung gibt es auch online: https://tools.pdf24.org/de/ocr-pdf